เริ่มจากปัญหาที่เจอกันทุกวัน
สมมติว่าคุณกำลังพยายามจำแนกพื้นที่ปลูกยางพาราในจังหวัดบึงกาฬจากภาพดาวเทียม คุณโหลดโมเดล Deep Learning ที่มีชื่อเสียงมาจาก GitHub ซึ่งนักวิจัยต่างประเทศ train ไว้บนข้อมูลจากหลายทวีป แล้วรันกับพื้นที่ของคุณ ผลที่ได้? ไม่ค่อยดีนัก โมเดลสับสนระหว่างยางพารากับป่าผลัดใบ หรือจำแนกนาข้าวผิดประเภทซ้ำแล้วซ้ำเล่า
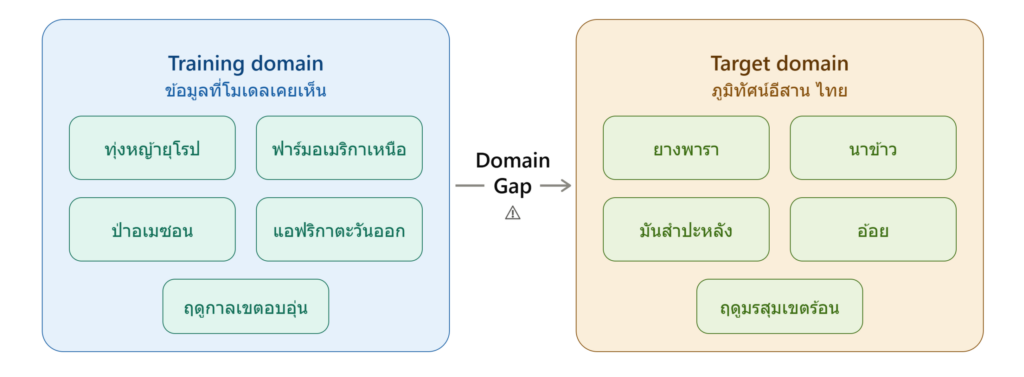
ปัญหานี้มีชื่อเรียกในวงวิชาการว่า domain gap หมายความว่า ลักษณะของข้อมูลที่โมเดลเรียนรู้มา (เช่น ทุ่งหญ้าในยุโรป ป่าในอเมซอน) แตกต่างจากข้อมูลที่คุณต้องการใช้งานจริง (ภูมิทัศน์เขตร้อนชื้นในอีสาน) จนโมเดลปรับตัวไม่ได้
แนวคิดที่กำลังเปลี่ยนวิธีรับมือกับปัญหานี้คือ Earth Embeddings หรือที่เรียกในวงกว้างว่า Geospatial Foundation Models — และนั่นคือสิ่งที่บทความนี้จะพาไปทำความรู้จัก
Foundation Model คืออะไร — เปรียบก่อนให้เข้าใจ
ก่อนจะเข้าใจ Earth Embeddings ต้องเข้าใจแนวคิดของ Foundation Model (โมเดลรากฐาน) ก่อน
ลองนึกถึง ChatGPT หรือ Claude ที่หลายคนคุ้นเคย โมเดลเหล่านี้ไม่ได้ถูกสร้างมาเพื่องานใดงานหนึ่งโดยเฉพาะ แต่ถูก train บนข้อความจำนวนมหาศาลจากอินเทอร์เน็ต หนังสือ และบทความต่าง ๆ จนมันเข้าใจภาษา บริบท และความสัมพันธ์ของแนวคิดในวงกว้าง เมื่อเราต้องการใช้งานจริง ไม่ว่าจะแปลภาษา สรุปรายงาน หรือเขียนโค้ด เราไม่ต้อง train โมเดลใหม่จากศูนย์ แค่ fine-tune (ปรับแต่ง) เพียงเล็กน้อยก็ได้ผลดี
Earth Embeddings คือแนวคิดเดียวกัน แต่สำหรับภาพดาวเทียม
แทนที่จะ train บนข้อความ โมเดลเหล่านี้ถูก train บนภาพดาวเทียมนับล้านถึงพันล้านภาพ ครอบคลุมทุกมุมโลก ทุกฤดูกาล หลายช่วงความยาวคลื่น (Bands) ตั้งแต่แสงที่ตาเห็นได้ไปจนถึงคลื่นไมโครเวฟจาก SAR โมเดลจึง “เข้าใจ” ลักษณะของพื้นผิวโลกในระดับลึก ก่อนที่เราจะบอกว่าต้องการทำอะไรกับมัน
Embedding คืออะไร — หัวใจของเรื่องทั้งหมด
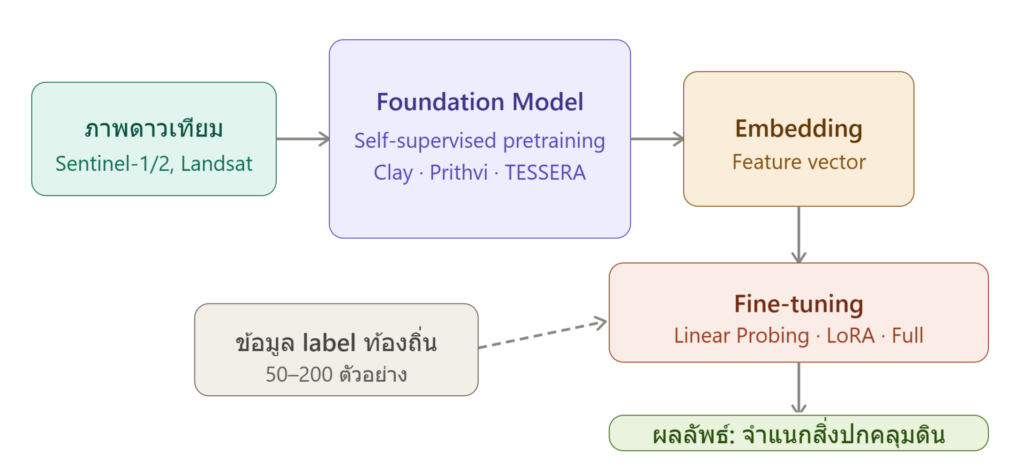
คำว่า Embedding คือการแปลงข้อมูลดิบ (ในที่นี้คือภาพดาวเทียม) ให้กลายเป็น เวกเตอร์ตัวเลข (vector of numbers) ที่มีความหมายเชิงความหมาย (semantic meaning)
ฟังดูซับซ้อน ลองเปรียบแบบนี้:
ถ้าคุณบอกให้คนคนหนึ่งดูภาพนาข้าวสีเขียว แล้วถามว่า “นี่คืออะไร?” เขาจะตอบได้ทันที เพราะสมองของเขาเคยเห็นและ “เข้าใจ” นาข้าวมาแล้ว กระบวนการนี้คือสิ่งที่ Embedding ทำ — แต่ทำในรูปแบบของตัวเลขที่คอมพิวเตอร์เข้าใจได้
เมื่อโมเดลสร้าง Embedding ของภาพดาวเทียมชิ้นหนึ่ง นาข้าวในอีสานและนาข้าวในเวียดนามจะมี Embedding ที่ใกล้เคียงกัน แม้ภาพจะถ่ายต่างเวลาและต่างดาวเทียม นั่นแหละคือพลังของมัน
โมเดลหลักที่ควรรู้จัก
ปัจจุบันมีโมเดล Earth Embeddings ที่เปิดใช้งานสาธารณะอยู่หลายตัว แต่ละตัวมีจุดเด่นต่างกัน:
| โมเดล | องค์กรที่พัฒนา | ข้อมูลที่ train | จุดเด่น |
|---|---|---|---|
| Clay | Clay Foundation | Sentinel-1, Sentinel-2, NAIP, LINZ | เปิด open-source เต็มรูปแบบ, ใช้งานง่าย |
| Prithvi | NASA + IBM | Sentinel-2, Landsat | เชี่ยวชาญภัยพิบัติและการเปลี่ยนแปลงสภาพแวดล้อม |
| TESSERA | ESA | Sentinel-1, Sentinel-2, time-series | ออกแบบมาสำหรับข้อมูล time-series โดยตรง |
| SatMAE | นักวิจัย Stanford | ภาพดาวเทียมความละเอียดสูง | แม่นยำสำหรับ object detection |
ทั้งหมดนี้สามารถดาวน์โหลดและทดลองใช้ได้ผ่าน Hugging Face โดยไม่มีค่าใช้จ่าย
หมายเหตุสำหรับนักวิจัย: ตาราง ณ วันที่เขียนบทความนี้ (กันยายน 2569) อาจมีโมเดลใหม่เพิ่มขึ้น ควรตรวจสอบ paperswithcode.com อยู่เสมอ
โมเดลทำงานอย่างไร — เข้าใจโดยไม่ต้องรู้คณิตศาสตร์
กระบวนการหลักที่ทำให้ Earth Embeddings เกิดขึ้นได้เรียกว่า Self-Supervised Learning (การเรียนรู้ด้วยตัวเอง โดยไม่ต้องมี label)
วิธีการทำงานโดยสรุป:
- ซ่อนข้อมูลบางส่วน — โมเดลได้รับภาพดาวเทียมที่ถูกปิดบังบางส่วน (เหมือนปริศนาต่อชิ้น) แล้วต้องทำนายส่วนที่หายไป
- เรียนรู้โครงสร้าง — เพื่อจะทำนายได้ถูกต้อง โมเดลต้องเรียนรู้ว่า “นาข้าวในช่วงเดือนพฤษภาคมมีลักษณะอย่างไร” หรือ “ป่าดิบชื้นตอบสนองต่อคลื่น SAR อย่างไร”
- สร้าง Embedding — ความรู้ทั้งหมดนั้นถูกบีบอัดลงใน Embedding ที่กะทัดรัด
กระบวนการนี้ไม่ต้องการ label จากมนุษย์เลย จึงสามารถ train บนข้อมูลดาวเทียมที่มีอยู่มหาศาลได้โดยตรง
ทำไมถึงสำคัญกับนักภูมิสารสนเทศไทยเป็นพิเศษ
ปัญหา Domain Gap กับภูมิทัศน์ไทย
ภาพดาวเทียมของประเทศไทย โดยเฉพาะภาคอีสาน มีลักษณะเฉพาะที่โมเดลต่างประเทศไม่คุ้นเคย:
- พืชผล เช่น มันสำปะหลัง อ้อย ยางพารา มีรูปแบบ Spectral Signature ต่างจากพืชในยุโรปหรืออเมริกา
- ฤดูกาล รอบการเพาะปลูกในเขตร้อนไม่ตรงกับที่โมเดลเคยเรียนรู้
- ความหลากหลายของ Land Use เช่น พื้นที่การเกษตรขนาดเล็กสลับกับป่า ต่างจากฟาร์มขนาดใหญ่ในประเทศที่พัฒนาแล้ว
Earth Embeddings ช่วยได้อย่างไร
แทนที่จะ train โมเดลจากศูนย์ (ซึ่งต้องการข้อมูล label นับพัน ๆ แปลง และ GPU จำนวนมาก) เราใช้ Earth Embeddings เป็นจุดเริ่มต้น แล้ว fine-tune ด้วยข้อมูลท้องถิ่นเพียงไม่กี่ร้อยตัวอย่าง
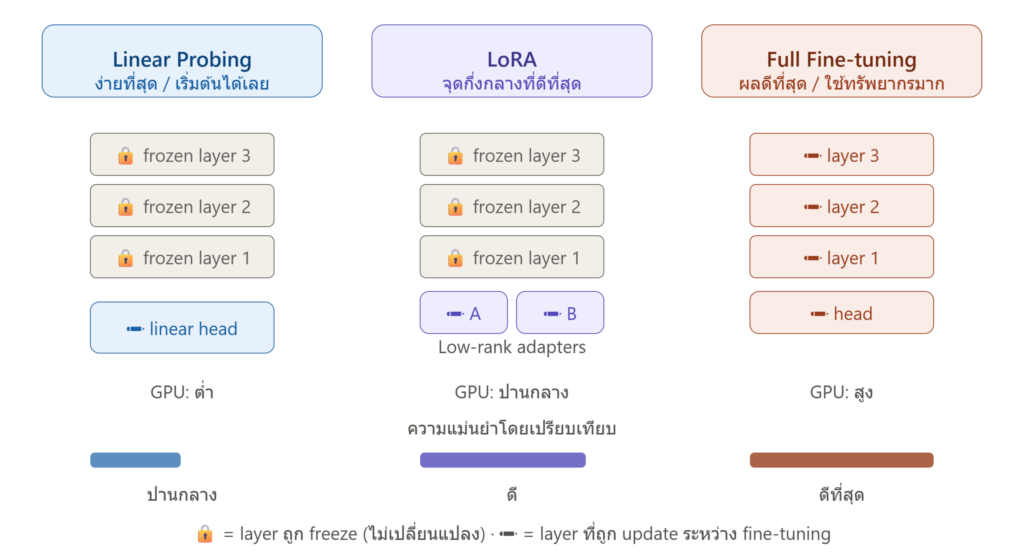
มีสามวิธีหลักในการ fine-tune:
- Linear Probing — แช่แข็ง (freeze) โมเดลทั้งหมด เพิ่มแค่ layer สุดท้ายสำหรับงานที่ต้องการ วิธีนี้ใช้ทรัพยากรน้อยที่สุด เหมาะสำหรับการทดลองเบื้องต้น
- Full Fine-tuning — ปรับทุก parameter ของโมเดล ให้ผลดีที่สุดแต่ต้องใช้ GPU และข้อมูล label มากกว่า
- LoRA (Low-Rank Adaptation) — จุดกึ่งกลางที่ชาญฉลาด ปรับเฉพาะส่วนที่สำคัญของโมเดลด้วยพารามิเตอร์น้อย แต่ได้ผลใกล้เคียง Full Fine-tuning — กำลังได้รับความนิยมอย่างมากในงานวิจัยปัจจุบัน
ตัวอย่างประยุกต์ใช้ในบริบทไทย
- การติดตามยางพาราเพื่อรองรับ EUDR — กฎระเบียบของสหภาพยุโรปที่กำหนดให้สินค้าต้องไม่มาจากพื้นที่ที่ถูกทำลายป่า การจำแนกพื้นที่ยางพาราอย่างแม่นยำจึงมีความสำคัญเชิงเศรษฐกิจโดยตรง
- การตรวจจับการเผา — ติดตามร่องรอยการเผาในช่วง PM2.5 สูงสุด โดยใช้ข้อมูล SAR ที่ทะลุเมฆได้
- การประเมินภัยแล้งและดินเค็ม — โจทย์สำคัญของเกษตรกรภาคอีสานที่ข้อมูล time-series จาก Sentinel-2 ช่วยได้มาก
เริ่มต้นใช้งานได้อย่างไร
สิ่งที่ต้องมี
| สิ่งที่ต้องการ | ระดับที่แนะนำ |
|---|---|
| Python | รู้ pandas, numpy พื้นฐาน |
| PyTorch / HuggingFace | เคยใช้มาบ้าง |
| GPU | แนะนำ แต่ Google Colab ฟรีก็เริ่มได้ |
| ข้อมูลดาวเทียม | Sentinel-2 / Sentinel-1 จาก Copernicus Open Access Hub |
ลำดับการเริ่มต้นแนะนำ
- ทดลองกับ Clay — มี notebook ตัวอย่างที่ github.com/Clay-foundation/model พร้อมข้อมูลตัวอย่างให้รันทันที
- สร้าง Embedding จากพื้นที่ที่คุณสนใจ — ลองดึงภาพ Sentinel-2 จากพื้นที่ใดก็ได้ในไทย แล้วสร้าง Embedding เพื่อดูว่าโมเดลแยกแยะสิ่งปกคลุมดินได้แค่ไหนโดยไม่ต้อง fine-tune
- ทดลอง Linear Probing — ใช้ข้อมูล label เพียง 50–100 แปลงแล้วดูว่าความแม่นยำเพิ่มขึ้นแค่ไหน
สรุป — Earth Embeddings ไม่ใช่อนาคต แต่คือปัจจุบัน
ถ้าคุณทำงานกับข้อมูลดาวเทียมในวันนี้ ไม่ว่าจะเป็นนักศึกษาที่กำลังทำวิทยานิพนธ์หรืออาจารย์ที่เตรียมข้อเสนอวิจัย Earth Embeddings ควรอยู่ใน toolkit ของคุณ ไม่ใช่เพราะมันเป็นของใหม่และน่าตื่นเต้น แต่เพราะมันแก้ปัญหาจริงที่เราเจอกันมานาน นั่นคือการขาดแคลนข้อมูล label สำหรับพื้นที่เฉพาะ
ข่าวดีคือ เครื่องมือเหล่านี้เปิดให้ใช้ฟรี ชุมชนนักวิจัยกำลังเติบโต และโจทย์ที่น่าสนใจในประเทศไทยยังรอคนมาทำอีกมาก